Superviser un réseau : détecter les pannes sans multiplier les alertes
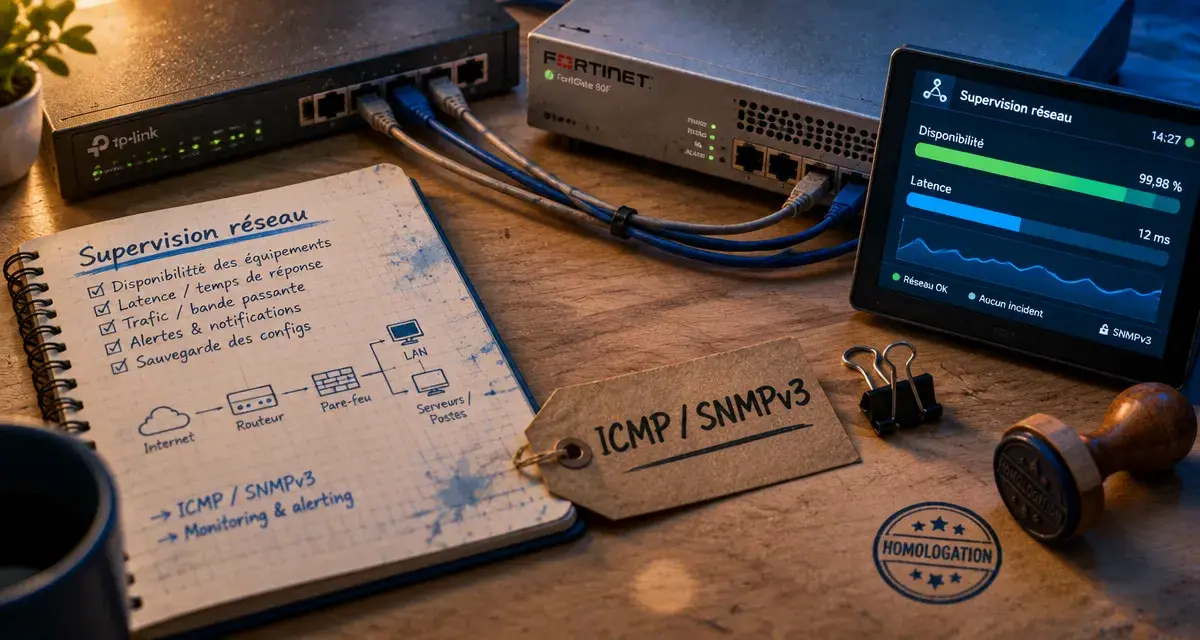
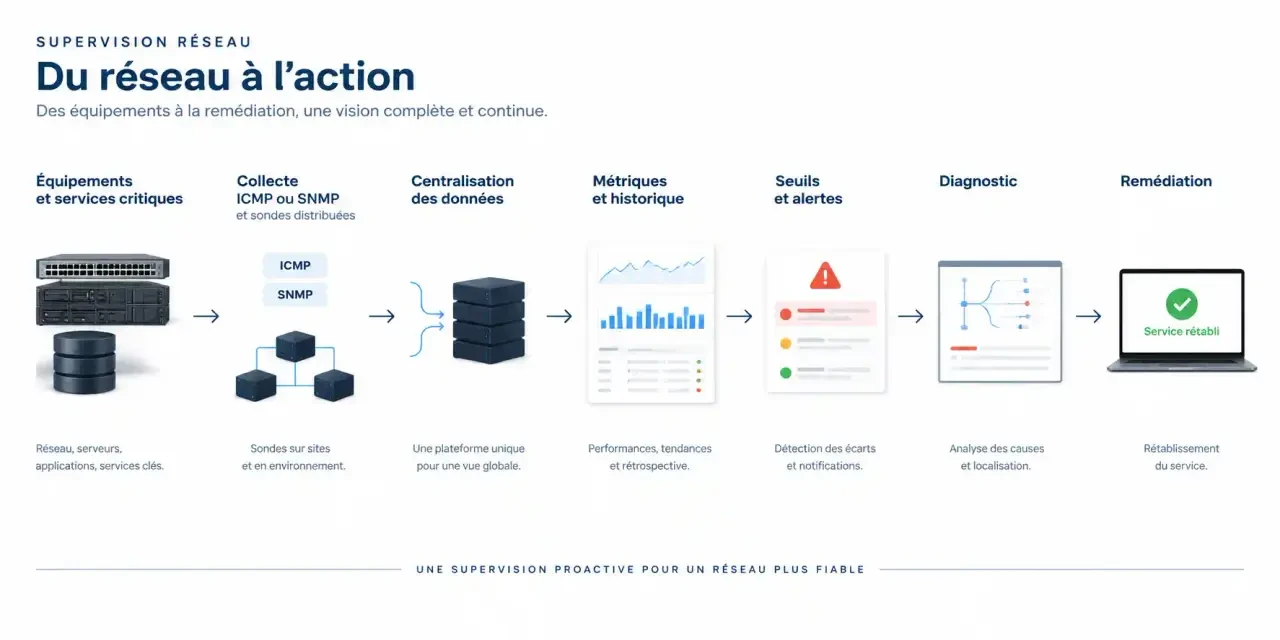
Superviser un réseau consiste à mesurer sa disponibilité, ses performances et l’état de ses équipements, puis à déclencher une alerte lorsqu’une intervention devient nécessaire. Pour obtenir une visibilité utile, commencez par les services critiques, choisissez les méthodes de collecte adaptées et attribuez chaque alerte à un responsable. L’outil vient ensuite : il doit faciliter le diagnostic, pas simplement accumuler des graphiques.
Définir le périmètre à partir des services indispensables
Un réseau peut sembler disponible alors qu’une application reste inaccessible. À l’inverse, un équipement peut ne plus répondre aux tests sans perturber les utilisateurs. La supervision doit donc relier l’état technique à l’impact métier. Identifiez d’abord les services indispensables : accès Internet, téléphonie, application de gestion, connexion entre agences ou accès au cloud.
Pour chacun, inventoriez les dépendances : routeurs, commutateurs, pare-feux, liaisons opérateur, points d’accès et services comme le DNS. Ajoutez les réseaux virtuels, hyperviseurs et conteneurs lorsqu’ils participent au chemin de communication. Une découverte automatique facilite cet inventaire, mais ne remplace pas sa validation par l’équipe informatique.
Ne pas confondre réseau, serveurs et sécurité
La supervision réseau suit principalement les communications et les équipements qui les transportent. La supervision des serveurs examine aussi le processeur, la mémoire, l’espace disque et les entrées-sorties. La gestion des serveurs va plus loin : configuration, mises à jour et administration. Ces activités se complètent, sans être interchangeables.
Le terme « surveillance réseau » est souvent employé comme synonyme de supervision. Dans un cadre de sécurité, il peut toutefois désigner la recherche de communications suspectes. Un pic de trafic mérite une investigation, mais ne prouve pas une attaque : la supervision opérationnelle ne remplace pas les outils de détection de sécurité.
Il devient pertinent de formaliser cette démarche lorsque les incidents sont signalés d’abord par les utilisateurs, que les sites se multiplient ou que les vérifications manuelles prennent trop de temps.
Associer chaque mesure à une méthode de collecte
Pour superviser un réseau, combinez les tests de disponibilité, les métriques des interfaces et l’analyse des communications. Aucun protocole ne répond seul à toutes les questions. Le choix dépend aussi des fonctions réellement prises en charge par chaque équipement.
| Méthode | Usage principal | Limite à connaître |
|---|---|---|
| ICMP | Tester la joignabilité et le temps de réponse | Une réponse ne garantit pas qu’un service applicatif fonctionne. |
| SNMP | Interroger les interfaces, compteurs de trafic et états matériels | Les métriques accessibles varient selon les équipements. |
| Traps SNMP | Recevoir une notification envoyée par un équipement | À compléter par des interrogations régulières pour vérifier l’état courant. |
| NetFlow | Analyser les flux et identifier les communications consommatrices | Sa disponibilité et sa granularité dépendent de l’infrastructure. |
| WMI | Collecter des informations sur les systèmes Windows | Concerne surtout les serveurs, pas l’ensemble du réseau. |
Suivez la disponibilité, la latence, la perte de paquets, l’utilisation des liens et les erreurs d’interface. Pour la voix ou la visioconférence, ajoutez la gigue, c’est-à-dire la variation du délai d’acheminement. Une liaison chargée sans erreurs ne raconte pas la même histoire qu’une liaison peu utilisée mais instable.
Conservez un historique exploitable pour distinguer une pointe normale d’une dégradation progressive. Un ralentissement récurrent pendant les sauvegardes peut révéler une concurrence sur la bande passante ; des erreurs apparues après une intervention orientent plutôt vers un changement technique à examiner.
Adaptez enfin la fréquence de collecte à la criticité. Des interrogations trop rapprochées augmentent la charge des équipements, du stockage et de la plateforme. Protégez les identifiants, limitez les droits de lecture et privilégiez les mécanismes sécurisés disponibles, notamment SNMPv3 lorsque les équipements le permettent.
Déployer des sondes et des alertes qui aident à agir
Commencez sur un périmètre pilote représentatif : une liaison critique, quelques commutateurs, un pare-feu et un service utilisé quotidiennement. Cette étape permet de vérifier la collecte, les notifications et le temps nécessaire à l’administration avant de généraliser.
- Validez l’inventaire : nom, emplacement, responsable et criticité de chaque composant.
- Positionnez la collecte : depuis le réseau central et, si nécessaire, depuis les sites distants.
- Observez le fonctionnement habituel : périodes chargées, traitements planifiés et variations attendues.
- Configurez les alertes : condition, durée de persistance, destinataire et procédure associée.
- Testez la chaîne complète : simulez une indisponibilité contrôlée et vérifiez la notification puis le retour à la normale.
Dans une architecture multisite, des sondes ou proxys distribués permettent de collecter localement tout en centralisant les résultats. Vérifiez leur comportement lorsque la liaison avec la plateforme est coupée : une perte de visibilité ne doit pas être confondue avec une panne de tous les équipements du site.
Une carte réseau gagne à être pensée comme un patron de couture : les pièces comptent, mais leurs raccords déterminent la solidité de l’ensemble. Documentez les jonctions entre réseau local, opérateur et cloud, avec le responsable de chaque interface. Lorsqu’un service ralentit, ces « marges de raccord » deviennent des points de contrôle concrets : où s’arrête votre visibilité, qui peut tester le segment suivant et quelles mesures comparer ?
Réduire le bruit sans masquer les incidents
Évitez les alertes déclenchées sur une seule mesure isolée. Pour une liaison, associez par exemple une utilisation durablement élevée à une dégradation du temps de réponse. Prévoyez des seuils de déclenchement et de retour à la normale distincts pour limiter les notifications répétitives autour d’une même valeur.
Déclarez les fenêtres de maintenance et les dépendances : si le routeur d’un site tombe, les équipements situés derrière ne doivent pas tous générer une notification indépendante. Chaque alerte doit préciser l’impact, le premier contrôle à effectuer et le destinataire d’escalade si elle reste sans traitement.
Comparer les outils sur leur adéquation au terrain
Une comparaison utile repose sur les mêmes scénarios de test, plutôt que sur le nombre de fonctions annoncé. Vous pouvez évaluer des solutions comme Nagios, Zabbix, PRTG ou Pandora FMS, en vérifiant les capacités de l’édition envisagée et les éventuels modules nécessaires.
Référentiel officiel du protocole SNMPv3 et de sa sécurité : Consultez les documents et spécifications RFC du groupe de travail IETF consacrés à SNMPv3, notamment au modèle de sécurité basé sur l’utilisateur (USM).
- Couverture : protocoles, découverte automatique, topologie, environnements virtuels et ressources cloud.
- Exploitation : personnalisation des alertes, tableaux de bord, rapports et gestion des droits.
- Intégration : API, création de tickets ITSM et rapprochement avec la CMDB.
- Évolution : collecte distribuée, rétention historique et comportement sous charge.
- Maintenance : mises à jour, documentation, support et compétences nécessaires.
Une solution open source peut convenir à une équipe capable de maintenir ses collecteurs et ses configurations. Une offre commerciale peut apporter un accompagnement, selon le contrat. Le SaaS réduit certaines tâches d’hébergement, mais impose d’examiner la localisation des données, la connectivité et les possibilités de collecte locale.
Comparez le coût total de possession : licence ou abonnement, hébergement, stockage, formation, intégrations et temps d’administration. Testez également la croissance prévue : un pilote fonctionnel ne démontre pas à lui seul la capacité à absorber tout le parc.
Transformer les mesures en décisions d’exploitation
Après chaque incident significatif, rapprochez les courbes, les événements et les changements de configuration. Documentez la cause identifiée et corrigez les règles devenues inutiles. Une automatisation de remédiation doit rester limitée à des actions maîtrisées, traçables et réversibles.
Utilisez les tendances pour préparer les augmentations de capacité, plutôt que décider sur un pic isolé. Pour suivre un SLA, définissez précisément le service mesuré, le point d’observation et les exclusions prévues au contrat. La disponibilité d’un routeur ne suffit pas à démontrer celle d’une application.
Enfin, surveillez la plateforme de supervision elle-même : collecte interrompue, stockage saturé ou notifications défaillantes créent des angles morts. Une supervision fiable se reconnaît à sa capacité à déclencher la bonne intervention, puis à éclairer la prochaine décision.
- Destruction de disque dur : un trou ne suffit pas à protéger vos données - 9 novembre 2026
- Hébergement HDS : six activités à vérifier avant de signer - 8 novembre 2026
- Configurer une adresse IP statique sur son ordinateur sans perdre Internet - 6 novembre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Logiciel de gestion de données : choisir entre stockage, intégration et analyse
 SafeVault Business : la capacité ne suffit pas à choisir son stockage cloud d’entreprise
 Qu’est-ce que challenges.cloudflare.com ? Vérification de sécurité et accès bloqué
 Audit cybersécurité : des failles détectées aux corrections vraiment prioritaires